Предиктивная аналитика в поисковой выдаче выглядит одинаково на девяти страницах из десяти. Определение, список отраслей, методы, этапы внедрения, «коротко о главном». Прочитать можно за пять минут, применить нельзя ни на минуту.
Разговор с заказчиком выглядит иначе. У компании есть выгрузка из учетной системы, желание предсказывать отток или спрос и вопрос: хватит ли этих данных вообще. Ответ дается до выбора платформы и до найма аналитика, и стоит дешевле обоих шагов.
Дальше разбор по частям. Чем прогноз отличается от отчета. Как отличить рабочий признак от совпадения за один день. Пять требований к данным, без которых модель считает шум. Где данные обычно оказываются не готовы. Сколько стоят российские платформы по публичным прайсам на 10 сентября 2026 года.
Чем прогноз отличается от отчета
Аналитика делится на четыре слоя, и они не взаимозаменяемы. Описательная показывает, что было: выручка за квартал, остатки на складе, число заявок. Диагностическая ищет причину. Предиктивная дает оценку будущего с вероятностью. Прескриптивная предлагает действие.
Практическая разница в цене ошибки. Отчет с ошибкой видно сразу: сумма не сходится с первичкой. Прогноз с ошибкой не видно вообще, пока не наступит срок, а к тому времени по нему уже приняли решение о закупке или о найме.
| Слой | Вопрос | Что нужно от данных | Чем меряется качество |
|---|---|---|---|
| Описательная | Что было | Полнота и сверка с первичным документом | Расхождение с источником |
| Диагностическая | Почему так вышло | Связи между таблицами, единый ключ клиента | Воспроизводимость разбора |
| Предиктивная | Что будет дальше | История событий и признаки, известные до события | Ошибка прогноза на прошлых периодах |
| Прескриптивная | Что делать | Стоимость действия и стоимость ошибки | Эффект решения в деньгах |
Компании обычно приходят за третьей строкой, находясь на первой. Пропустить вторую не получится: если клиент в CRM и клиент в биллинге не связаны одним ключом, модель не увидит историю ни одного клиента целиком.
Как отличить предиктор от совпадения
Признак, который «явно влияет», и признак, который действительно предсказывает, различаются процедурой проверки. Она короткая и не требует ни платформы, ни специалиста по машинному обучению: аналитик делает ее на выгрузке за день.
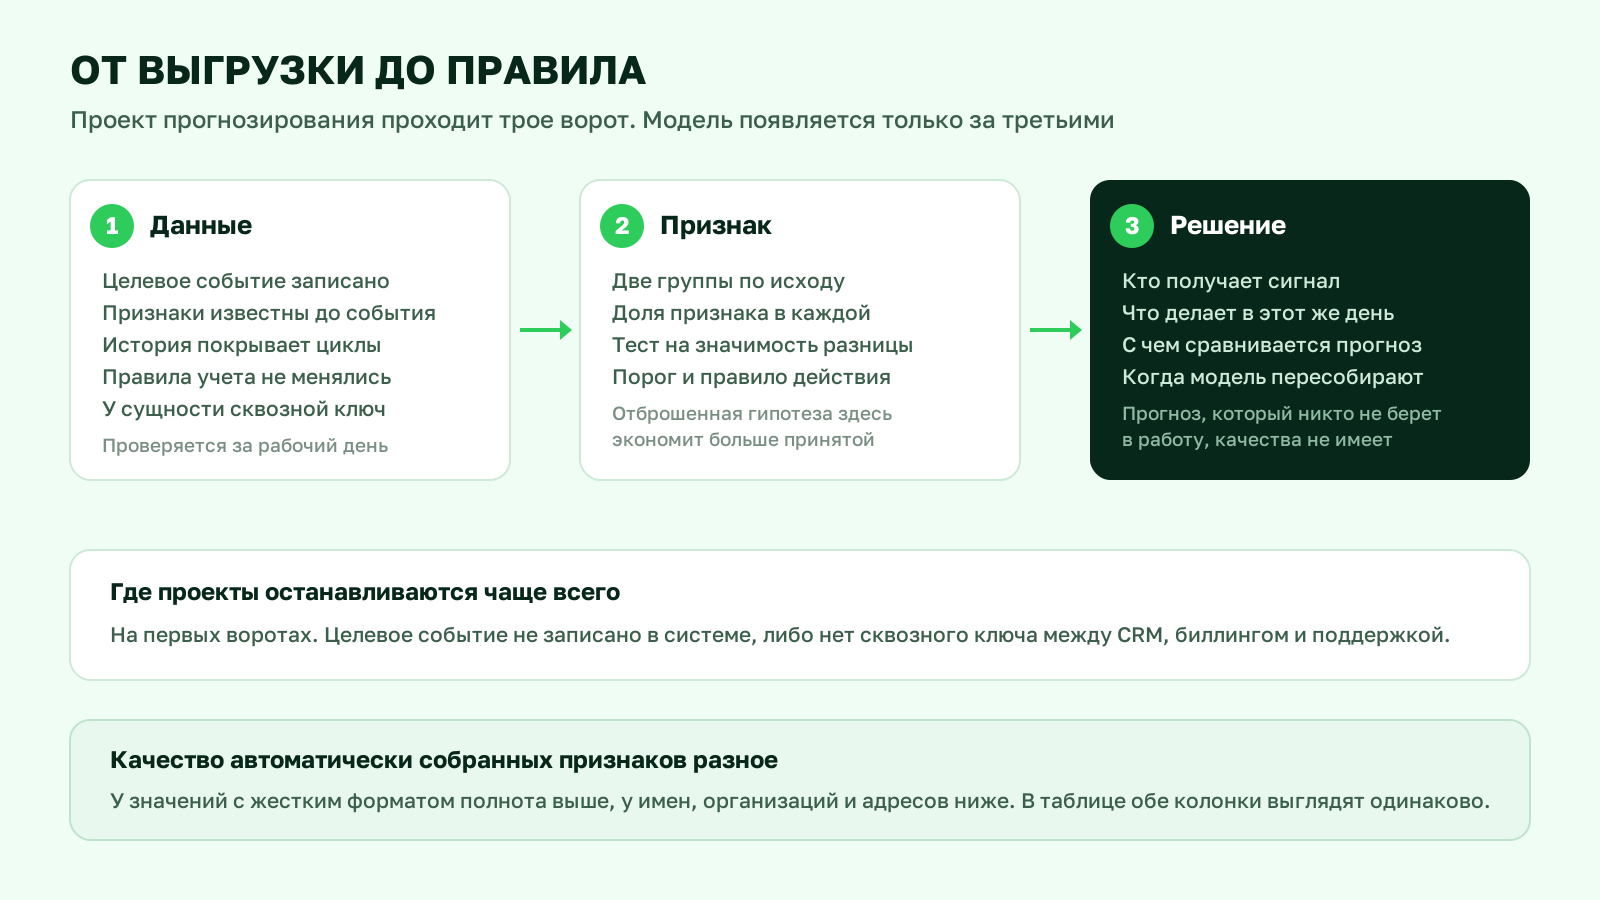
Разделить историю на две группы по исходу. Те, у кого целевое событие наступило, и те, у кого не наступило. Обе группы берутся за один период, иначе разница между ними окажется разницей между месяцами.
Сравнить долю признака в группах, а не среднее по всей базе. Фраза «у ушедших клиентов было мало обращений» ничего не значит, пока рядом нет той же цифры по оставшимся.
Проверить разницу на значимость. Для доли это точный тест Фишера или тест хи-квадрат, они считаются в любой статистической библиотеке за одну строку. Разница в пять пунктов на выборке из тридцати наблюдений это шум, а не сигнал.
Перевести подтвержденный признак в порог и правило. Прогноз имеет смысл только тогда, когда из него получается действие: при каком значении признака и что именно делает менеджер сегодня.
Что здесь дает больше всего пользы
Отброшенная гипотеза экономит больше подтвержденной. Самое распространенное объяснение проблемы обычно звучит убедительно и приходит из отраслевых руководств, а на конкретной выборке не подтверждается. Пока его не проверили статистикой, компания месяцами лечит не ту причину, и это стоит дороже, чем весь проект по аналитике.
Отсюда же следует нижняя граница по объему. Тест на значимость требует, чтобы целевое событие в выборке встречалось десятки раз. Если ушедших клиентов за всю историю пятеро, никакая платформа этого не исправит: сначала нужно накопить события, и это отдельная работа со своим сроком.
Пять требований к данным
Требования ниже проверяются на выгрузке за один рабочий день, до разговора о платформе и о найме дата-сайентиста.
Целевое событие записано явно. Модель учится предсказывать то, что помечено в данных. «Клиент ушел» должно быть строкой с датой, а не выводом менеджера. Если признака ухода в системе нет, первым проектом становится не прогноз, а его фиксация.
Признаки известны до события. Самая частая ошибка внедрения: в обучающую выборку попадает поле, которое заполняется уже после наступления события. Модель показывает отличное качество на тесте и разваливается в бою, потому что в бою этого поля еще нет.
Истории хватает на несколько циклов. Для сезонного спроса это минимум два полных года, иначе сезонность не отделить от тренда. Для оттока это несколько сотен состоявшихся уходов, а не несколько сотен клиентов.
Правила игры не менялись внутри выборки. Смена тарифной сетки, переезд на другую CRM, изменение методики учета разрезают историю пополам. Данные до и после такого события в одну выборку не складываются без пометки.
У сущности есть сквозной ключ. Один клиент в CRM, в биллинге и в поддержке должен опознаваться одним идентификатором. Без этого история собирается вручную и на каждом обновлении собирается заново.
Список выглядит скучно ровно до момента, когда по нему проверяют реальную выгрузку. Обычно два пункта из пяти не выполняются, и это и есть содержание первого этапа работ.
Где данные оказываются не готовы
Первый этап любого проекта прогнозирования это инвентаризация: где физически лежат данные и кто их пишет. Поле в базе выглядит одним источником, а на деле в него пишут несколько программ: форма сайта, обработчик почты, выгрузка из внешнего сервиса, ручная правка администратора. Часть обработчиков живет вне системы контроля версий, поэтому смена формата поля происходит без следа в истории. Модель, обученная на таком поле, узнает об этом последней и молча начинает считать шум.
Проверка, которая закрывает вопрос за день: выписать все программы и людей, имеющих право записи в целевые таблицы, и для каждой строки ответить, где лежит ее код и кто отвечает за формат. Каждый источник без ответа это будущий разрыв в обучающей выборке.
Вторая половина инвентаризации это копии. Рядом с рабочей базой обычно находятся выгрузки, сделанные для разовых задач и оставшиеся лежать: их не удаляют, срок хранения под них не задан, а персональные данные в них те же самые. Как разобрать такой контур по шагам, описано в материале про аудит персональных данных и оценку эффективности мер.
Задачи, где прогноз окупается в среднем бизнесе
| Задача | Горизонт | Что нужно от данных | Как понять, что модель полезна |
|---|---|---|---|
| Отток клиентов | 1-3 месяца | История платежей, обращений, активности | Доля удержанных из тех, кого пометили |
| Прогноз спроса | Неделя, месяц | Два и более полных года продаж по позициям | Ошибка прогноза против прошлого метода |
| Скоринг входящих заявок | Дни | Исходы прошлых заявок, включая отказы | Сколько времени менеджера освободилось |
| Отказ оборудования | Дни, недели | Телеметрия и журнал ремонтов за годы | Предупрежденные простои |
| Просрочка платежа | Недели | Платежная дисциплина по контрагенту | Сокращение дебиторки |
Правая колонка важнее левой. Модель оценивают не процентом точности, а тем, что изменилось в работе людей. Если прогноз оттока никто не берет в работу, его качество не имеет значения.
Когда признаки собирает машина
Часть признаков для модели редко лежит готовой колонкой. Их вытаскивают из документов, писем и свободного текста автоматическим разбором, и качество этой сборки становится качеством всей выборки.
Движок извлечения сущностей, который мы разрабатываем, замеряли 20 августа 2026 года. Выборка 2867 текстов и 4585 размеченных сущностей, методика: засчитывается попадание по отдельной сущности. Покрытие 92,5 процента, пропущено 344, ложных срабатываний 301. Полноту автоматического обнаружения мы не гарантируем и пишем это в договор.
Важна не общая цифра, а разрез. У значений с жестким форматом и контрольной цифрой полнота выше, у имен, названий организаций и адресов ниже. Признак «регион клиента», собранный разбором свободного текста, и признак «сумма договора», взятый из поля базы, приходят в модель с разной надежностью, а в таблице выглядят одинаково.
То же касается готовых библиотек. Открытая библиотека разбора русского текста, которую мы проверяли в августе 2026 года, размечает имена, организации и локации, но не размечает телефон и электронную почту, а найденное скрывает целиком, без сохранения формата. Взять ее «из коробки» под задачу, где нужны именно контакты, не выйдет: набор типов у инструмента и набор типов у задачи совпадают редко.
Отсюда правило для любого слайда с процентом качества. Первый вопрос: что считалось единицей, документ или отдельное поле. Второй: на каком контуре шел замер, на демонстрационном стенде или на рабочей системе. Одна и та же система при разных ответах на эти два вопроса дает разные числа без единой правки в модели. Подробнее проверка разобрана в материале про проверку цифры в автоматическом отчете.
Сколько стоят платформы
Публичные прайсы российских вендоров, проверено 10 сентября 2026 года.
| Продукт и редакция | Назначение | Цена |
|---|---|---|
| Loginom Community | Настольная, некоммерческое использование | Бесплатно |
| Loginom Personal | Настольная, профессиональная аналитика | 119 000 руб. |
| Loginom в Yandex Cloud | Развертывание в облаке | от 14 400 руб. в месяц |
| Loginom Team | Серверная, группа до 5 человек | от 1 690 000 руб. |
| Loginom Enterprise | Серверная, крупная компания | от 11 990 000 руб. |
| AW BI, бессрочная лицензия | Роли: разработчик, аналитик, специалист | 55 000 / 25 000 / 15 000 руб., пакет от 10 пользователей |
Разброс между настольной редакцией и серверной стократный, и объясняется он не качеством алгоритмов, а контуром эксплуатации: права доступа, расписание, ответственность за результат.
Часть вендоров прогнозных решений публичного прайса не держит вовсе: у одного из проверенных страницы цен нет, у другого сайт не открылся на момент проверки. Суммы там называют в ответ на запрос, и это тоже информация о рынке.
Для компании, у которой первые два из пяти требований к данным не выполнены, любая из этих строк преждевременна. Сначала сквозной ключ и фиксация целевого события, потом лицензия.
Персональные данные в обучающей выборке
Выборка для прогноза оттока или скоринга почти всегда содержит персональные данные: имя, контакт, историю платежей. Три вещи, которые проверяются до начала работ.
Первое: основание обработки. Прогнозирование поведения клиента это отдельная цель, и она должна быть названа в документах, а не подразумеваться. Второе: где живет копия выборки. Файл, выгруженный аналитиком на ноутбук, живет дольше проекта. Третье: что уходит наружу, если модель считают в облаке или подсказку пишет внешний сервис.
Автоматическое маскирование помогает, но риск закрывают регламент и внедренная процедура, а не скрипт. Причина в спецификации любого такого инструмента: у полей без жесткого формата полнота обнаружения ниже, чем у документов и реквизитов с контрольной цифрой.
Проверка данных под прогноз
Смотрим вашу выгрузку по пяти требованиям, собираем карту источников и говорим прямо, хватает данных на прогноз или сначала нужен сбор. Работаем по часам: 2 500 руб. в час, оплата по факту, без аванса. Дальше подключаем прогноз к рабочему процессу через интеграции и автоматизацию процессов, а разбор ИИ-контура делаем в рамках услуги ИИ-аудита.
Частые вопросы
Сколько данных нужно, чтобы начать
Считать надо не строки, а события. Для прогноза оттока нужны несколько сотен состоявшихся уходов, для сезонного спроса минимум два полных года истории по позиции. Таблица на миллион строк, в которой целевое событие встречается двадцать раз, для обучения не годится.
Чем предиктивная аналитика отличается от машинного обучения
Машинное обучение это способ, предиктивная аналитика это задача. Часть прогнозов делается обычной статистикой и регрессией без единой нейросети, и такой прогноз проще объяснить проверяющему и заказчику.
Можно ли обойтись встроенными средствами CRM или BI
Для типовых задач вроде прогноза выручки по воронке встроенных средств часто хватает. Отдельная система нужна там, где данные лежат в нескольких источниках и их надо связать. Про сборку такого контура без покупки платформы разобрано в материале про сквозную аналитику на Метрике и CRM.
Как понять, что модель испортилась
Ошибку прогноза измеряют регулярно на новых периодах и сравнивают с базовым методом вроде «как в прошлом месяце». Если модель перестала обыгрывать базовый метод, ее пересобирают. Без такого замера деградацию замечают по жалобам, то есть поздно.
Сколько занимает первый этап
Проверка выгрузки по пяти требованиям и карта источников это несколько рабочих дней. Дальше срок зависит от того, сколько требований не выполнено: сбор недостающих данных обычно дольше, чем построение самой модели.
Коротко
Предиктивная аналитика начинается с выгрузки, а не с платформы. Целевое событие должно быть записано, признаки должны быть известны до события, история должна покрывать несколько циклов, правила учета внутри выборки не должны меняться, у сущности должен быть сквозной ключ. Гипотезу проверяют статистикой, и отброшенный признак экономит больше, чем подтвержденный. Процент качества без описания методики счета не значит ничего.
Обсудим вашу задачу
Оставьте контакт: ответим в течение 2 часов в рабочее время. Оценка бесплатная, аванс не нужен.