ИИ для маркетинга: задачи, риски и проверка
Запрос «ии для маркетинга» собирает в Яндексе 409 показов в месяц, «нейросеть в маркетинге» еще 213, «нейросети для маркетолога» 153. Замер по России от 21 сентября 2026 года. Все десять страниц первой десятки выдачи по головному запросу это перечисления инструментов и направлений: чем генерировать тексты, чем резать видео, чем собирать сегменты.
Список инструментов отвечает на вопрос «что открыть». Он не отвечает на два других вопроса, которые возникают на второй неделе работы. Первый: по какому признаку принимать то, что модель выдала. Второй: что происходит с клиентскими данными, которые маркетолог кладет в запрос, чтобы ответ получился точнее.
Дальше разбор по обоим. Какие задачи нейросеть в маркетинге закрывает без спора. Где проходит граница доверия и что на этой границе проверяет человек. Что происходит с выгрузкой клиентской базы после отправки в чат. Как устроен порядок приемки результата. Сколько стоят такие сервисы по публичным прайсам на 21 сентября 2026 года.
Какие задачи нейросеть закрывает без спора
Короткий список, где модель экономит часы и почти не создает риска.
Черновик и варианты формулировок. Десять заголовков для теста объявления, пять вариантов темы письма, структура лендинга по описанию продукта. Здесь ценна скорость перебора, а качество все равно решает человек на этапе отбора.
Переупаковка готового материала. Вебинар на час превращается в пятнадцать коротких клипов с субтитрами. Один длинный текст раскладывается на пост в Телеграм, карточки для ВКонтакте и сценарий для короткого видео. Исходник проверен заранее, модель меняет только форму.
Разбор обратной связи. Триста комментариев под постом классифицируются по темам и тональности за минуту. Дальше человек читает не все триста, а десять характерных из каждой группы.
Черновая аналитика. Модель формулирует гипотезы по выгрузке: где просела конверсия, какой сегмент вырос. Каждая гипотеза потом проверяется в отчете источника, а не принимается на веру.
Рутина с текстом. Описания товаров по шаблону, расшифровка созвона, перевод, вычитка. Задачи, где ошибка заметна сразу и стоит недорого.
Где проходит граница доверия
Граница проходит не по сложности задачи, а по цене ошибки и по тому, заметна ли ошибка глазом. Текст с логической дырой видно при вычитке. Неверную цифру в сводной таблице не видно никогда, потому что выглядит она ровно так же, как верная.
| Задача | Что делает модель | Что обязан проверить человек |
|---|---|---|
| Заголовки и офферы | Дает перебор вариантов | Соответствие продукту и обещанию на странице |
| Тексты объявлений | Собирает по шаблону | Требования площадки к рекламе, отраслевые ограничения |
| Статья в блог | Пишет черновик по структуре | Каждую цифру и каждую ссылку на источник |
| Разбор выгрузки | Формулирует гипотезу | Сверку с отчетом рекламной системы и с CRM |
| Работа с базой клиентов | Сегментирует, пишет персональные тексты | Состав данных до отправки в сервис |
| Публикация от имени бренда | Готовит материал целиком | Факты, цифры, юридические формулировки |
Нижняя строка таблицы отмечена намеренно. Ответственность за опубликованный текст несет компания, а не сервис, которым текст написан. Это относится и к рекламному объявлению, и к статье, и к рассылке.
Клиентская база в запросе к модели
Самая дорогая ошибка в этой теме выглядит безобидно. Маркетолог выгружает базу из CRM, чтобы модель разложила клиентов по сегментам и написала под каждый сегмент письмо. В выгрузке имена, телефоны, почты, адреса доставки, иногда суммы покупок. Файл отправляется в публичный чат.
С этого момента персональные данные обрабатываются на стороне сервиса, и обработчик этот в документах компании не описан. Оператор данных по закону отвечает за то, куда они ушли, и ссылка на то, что «это был просто чат», обстоятельством не является.
Второй слой проблемы технический. Обезличить выгрузку автоматически можно, но полнота такого обезличивания зависит от типа поля, и разница здесь большая. Замер детектора персональных данных от 20 августа 2026 года проведен на бенчмарке из 2867 сообщений и 4585 размеченных сущностей. Общее покрытие 92,5 процента при 301 ложном срабатывании. Дальше начинается разрез, ради которого этот замер и приводится.
Данные с жестким форматом находятся надежно: технические идентификаторы 98,8 процента, финансовые 98,0, государственные 97,8, контакты 97,6, документы 96,7. За ними стоят правила с проверкой контрольных цифр, и ошибиться там сложно.
Данные без формата ведут себя иначе: организации 92,8 процента, ФИО 87,3, адрес и геолокация 86,5. Из 344 пропусков на прогоне 287 приходятся ровно на эти три типа. Полнота автоматического обнаружения не гарантируется, и в договоре на разбор это оговаривается отдельной строкой.
Практический вывод для маркетолога простой. Колонка с телефоном или ИНН чистится автоматикой надежно. Колонка с именем клиента, названием его компании и адресом доставки остается наполовину открытой, и на экране эта разница не видна.
Что это значит на практике
Фраза «файл прогнали через обезличивание» не равна фразе «файл безопасен». Проверять нужно не факт прогона, а состав колонок, которые остались в файле.
Обезличивание в живом канале работает не так, как в презентации
Второй пример из инженерной практики, а не из теории. Разбор канала заявок от 10 августа 2026 года шел сразу по трем местам, куда попадают контакты человека, оставившего форму на сайте: тело почтового уведомления, база сайта и журнал ошибок.
Результат разбора: журнал оказался чист, в него писался только идентификатор заявки и адрес получателя. База выполняла роль легитимного хранилища под доступом. А вот почтовое уведомление уходило с полным набором в открытом виде: имя, телефон, почта, название компании, свободный текст задачи. Именно письмо расходится по ящикам шире всего и меньше всего контролируется.
Готовый инструмент обезличивания на основе распознавания именованных сущностей проверялся как решение и не подошел по двум причинам. Он закрывает имена, организации и локации, но не закрывает телефон и почту, а для заявки это главный персональный идентификатор. И он вырезает сущность целиком, вместо того чтобы оставить менеджеру узнаваемый остаток.
Рабочее решение оказалось скучнее. В горячем пути стоят детерминированные правила по каждому типу поля: имя остается целиком, фамилия сворачивается до первой буквы, у телефона видны первые и последние две цифры, у почты первые символы и домен целиком. Название компании остается открытым: это бизнес-идентификатор, менеджеру он нужен для квалификации. Полный контакт лежит в базе и открывается по ссылке под логином.
Вывод, который переносится на любой маркетинговый контур: модель хороша там, где нужно понять смысл, и плоха там, где нужна гарантия на каждом экземпляре. Гарантию дают правила, а не вероятностный ответ.
Цифра без источника ломает материал
Третья типовая ошибка касается контента. Модель, которую попросили написать убедительный текст, выдает убедительные цифры: доля рынка, процент экономии, срок окупаемости. Выглядят они правдоподобно, источника у них нет.
Редакционное правило здесь одно и работает без исключений: рядом с числом стоит источник и дата проверки, иначе число из текста убирается. Чужая цена берется с живой страницы поставщика в день публикации, а не из памяти модели, потому что прайсы меняются молча. Если нужной цифры нет, фраза переписывается без нее.
Цена нарушения этого правила не репутационная, а юридическая. Обещание результата в рекламе требует основания, а утверждение о превосходстве над конкурентами требует подтверждения. Текст, собранный нейросетью за три минуты, оснований не содержит.
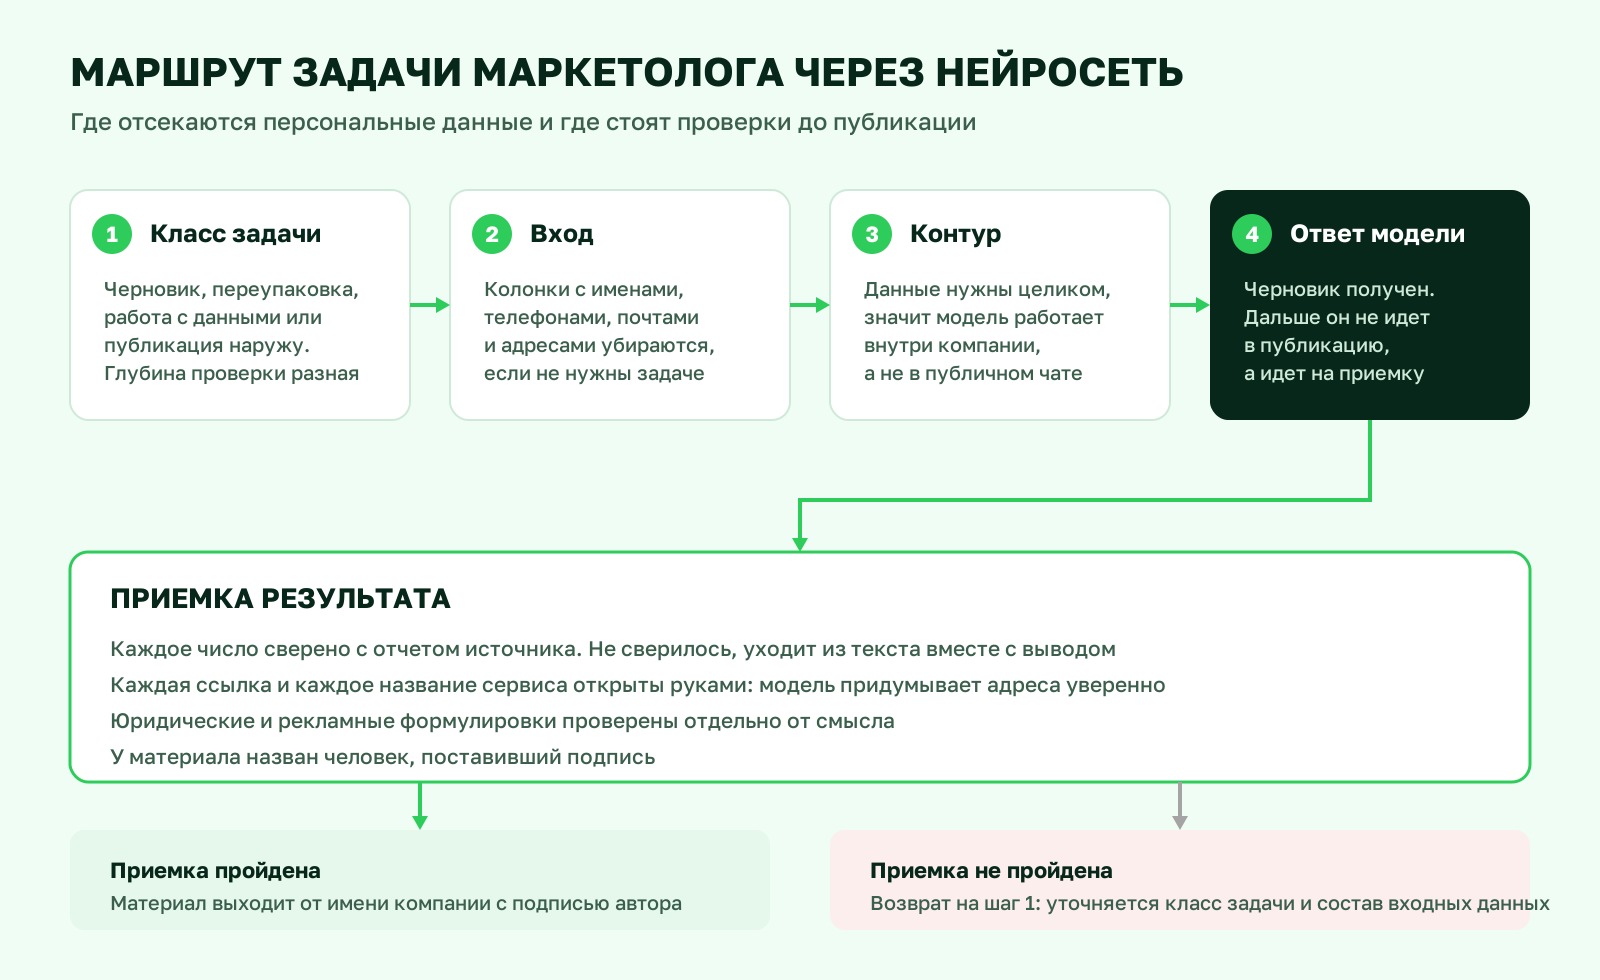
Порядок приемки результата
Процедура, которую стоит закрепить письменно и выдать каждому, кто пользуется моделью.
-
Определить класс задачи
Черновик, переупаковка готового, работа с данными или публикация наружу. От класса зависит глубина проверки. Пять минут.
-
Вычистить вход
Из файла убираются колонки с именами, телефонами, почтами и адресами, если они не нужны для задачи. Нужны, значит задача решается в контуре компании, а не в публичном чате.
-
Проверить каждое число
Цифра сверяется с отчетом источника. Не сверилась, убирается из текста вместе с выводом, который на ней построен.
-
Проверить ссылки и названия
Модель уверенно придумывает адреса страниц и названия сервисов. Каждая ссылка открывается руками.
-
Назвать ответственного
У опубликованного материала есть человек, поставивший подпись. Без этого шага предыдущие четыре не выполняются никогда.
Сколько стоят ИИ-инструменты маркетолога
Рынок берет деньги по-разному, и понимать модель оплаты полезнее, чем сравнивать цифры в лоб. Данные с публичных страниц поставщиков, проверены 21 сентября 2026 года.
| Решение | За что платят | Публичная цена |
|---|---|---|
| Roistat, сквозная аналитика | За визиты и число подключенных инструментов | Стартовый 6 500 ₽/мес до 20 000 визитов, Базовый 11 700 ₽/мес, Бизнес 19 700 ₽/мес, Премиум 40 400 ₽/мес |
| BotHelp, боты и ИИ-агенты | За каналы, подписчиков и пакет токенов | Пробный период 14 дней и 75 000 токенов, CREATOR 1 599 ₽/мес и 150 000 токенов, SCALE от 29 990 ₽/мес |
| Разработка под задачу | За фактически отработанные часы | 2 500 ₽/ч, оплата по факту, без аванса |
Подписка выгодна, пока задача укладывается в типовой сценарий поставщика. Как только нужен свой разрез данных, стыковка с внутренней системой или обработка персональных данных внутри контура компании, подписка упирается в границы продукта. Тарифы Yandex AI Studio и GigaChat в этот обзор не вошли: обе страницы на дату проверки не отдали цен автоматической проверке, а ставить неподтвержденные числа в таблицу нельзя.
Разбор ИИ-канала по выборке из 200 реальных текстов
Показываем, что нашли в вашей выборке: какие данные уходят наружу, через какие каналы и что закрывается регламентом, а что доработкой. 10 рабочих дней, 49 000 ₽. Пресейл-прогон бесплатный.
Если задача шире и касается стыковки моделей с внутренними системами, об этом отдельно в разделе автоматизация бизнес-процессов, а про сценарии с диалоговыми помощниками в разделе ИИ-агенты для бизнеса.
Вопросы и ответы
С какой задачи начинать внедрение ИИ в маркетинге
С той, где ошибка заметна сразу и стоит дешево: черновики, переупаковка готового материала, разбор комментариев. Задачи с деньгами и персональными данными берутся после того, как отлажен порядок приемки.
Можно ли загрузить выгрузку клиентов в публичный чат
Без обработки нельзя: персональные данные уйдут стороннему обработчику, не описанному в документах компании. Либо колонки с контактами и именами удаляются до отправки, либо задача решается моделью внутри контура компании.
Насколько надежно автоматическое обезличивание
Зависит от типа данных. По замеру от 20 августа 2026 года форматные типы находятся на уровне 96,7-98,8 процента, а ФИО, адреса и названия организаций заметно ниже: 87,3, 86,5 и 92,8 процента. Полнота обнаружения не гарантируется, автоматика остается вспомогательным слоем к регламенту.
Кто отвечает за ошибку в тексте, написанном нейросетью
Компания, опубликовавшая текст. Сервис генерации стороной в этих отношениях не является, поэтому подпись ответственного человека под материалом обязательна.
Заменит ли ИИ маркетолога
Вопрос поставлен неверно. Модель снимает объем и не снимает ответственность, поэтому меняется состав работы: меньше производства, больше постановки задачи и приемки результата.
Разберем ваш ИИ-канал в маркетинге
Покажем, какие данные уходят наружу через генерацию текстов, рассылки и ботов, и что с этим делать.