5 сентября 2026 года председатель Верховного суда России Игорь Краснов сообщил, что российские суды в пилотном режиме применяют четыре разные модели искусственного интеллекта. Модели обучаются на правовых позициях Верховного суда и практикообразующих судебных решениях. При Верховном суде создан Центр судебных компетенций в сфере искусственного интеллекта. Об этом написали РИА Новости.
Дальше в выдаче десять страниц про право и этику: допустимо ли, кто отвечает, как регулировать. Инженерной стороны не касается никто, а вопрос там простой и проверяемый: куда физически уезжает текст, когда его отдают модели, и сколько персональных данных из него успевает вычистить автоматика.
Это разбор для тех, кто уже запустил или собирается запустить модель на своих документах. Судебная система тут только повод: у бизнеса ровно та же схема, только вместо материалов дела договоры, медицинские карты, кадровые документы и переписка с клиентами. Цифры полноты обнаружения персональных данных приводятся по замеру от 20 августа 2026 года на выборке 2867 текстов, цены вендоров сняты с живых страниц 7 сентября 2026 года.
Что известно про пилот и чего в сообщении нет
В публичном заявлении названы четыре модели, обучающая база и цель: единообразие практики, отсутствие логических противоречий, предсказуемость правосудия. Это заявление, а не техническая документация, и относиться к нему надо соответственно.
Чего в сообщении нет, а для оценки риска нужно: где выполняется вывод модели, кто оператор инфраструктуры, обезличиваются ли материалы до подачи в модель, ведется ли журнал обращений и как долго он хранится. Пока этих ответов нет, обсуждать утечку конкретно в судебном пилоте не на чем.
Зато общая механика одинаковая у суда и у компании, и слабые места в ней называются заранее.
Где персональные данные оседают на самом деле
Массовое представление о риске такое: модель обучилась на персональных данных, значит запомнила и когда-нибудь выдаст. Риск существует, но он не первый ни по вероятности, ни по объему.
Порядок разбора любого контура, где текст с персональными данными проходит через автоматику, одинаковый. Проверяются три канала подряд: письмо, база, логи.
| Канал | Что в нем обычно лежит | Персональные данные |
|---|---|---|
| Письмо-уведомление ответственному | Имя, телефон, мессенджер, почта, компания, свободный текст обращения открытым текстом | Да, основной риск |
| База, карточка записи | Полный набор полей, хранение без заданного срока | Да, но под доступом по логину |
| Логи приложения | Идентификатор записи и адрес получателя, запись только при сбое отправки | Обычно нет |
Типовая находка идет вразрез с ожиданием. Логи, на которые ругается большинство чек-листов, чаще всего чисты. Течет почтовый канал: письмо с полным набором контактов расходится по ящикам, пересылается, оседает в клиентах на личных устройствах и живет там столько, сколько захочет получатель. Второй источник риска это хранение в базе без срока и без процедуры удаления.
Лечится это парой решений. Контакты в письме маскируются детерминированными правилами: имя до инициала фамилии, почта до двух символов локальной части, телефон первые две и последние две цифры. Полный набор данных остается в базе под доступом, а на записи ставится автоматическая очистка по сроку, например через 365 дней. Ответственный узнает обращение по имени и хвосту номера, а за полным контактом идет по ссылке под логином.
Готовые инструменты распознавания сущностей тут помогают не всегда. Типовой открытый инструмент маскирует имена, организации и локации, но не телефон и не почту, а это как раз основные контакты. Плюс он делает полную замену вместо частичного скрытия и требует сетевого вызова прямо в момент приема обращения. Ставить такой вызов в горячий путь рискованно: цена сбоя это потерянное обращение.
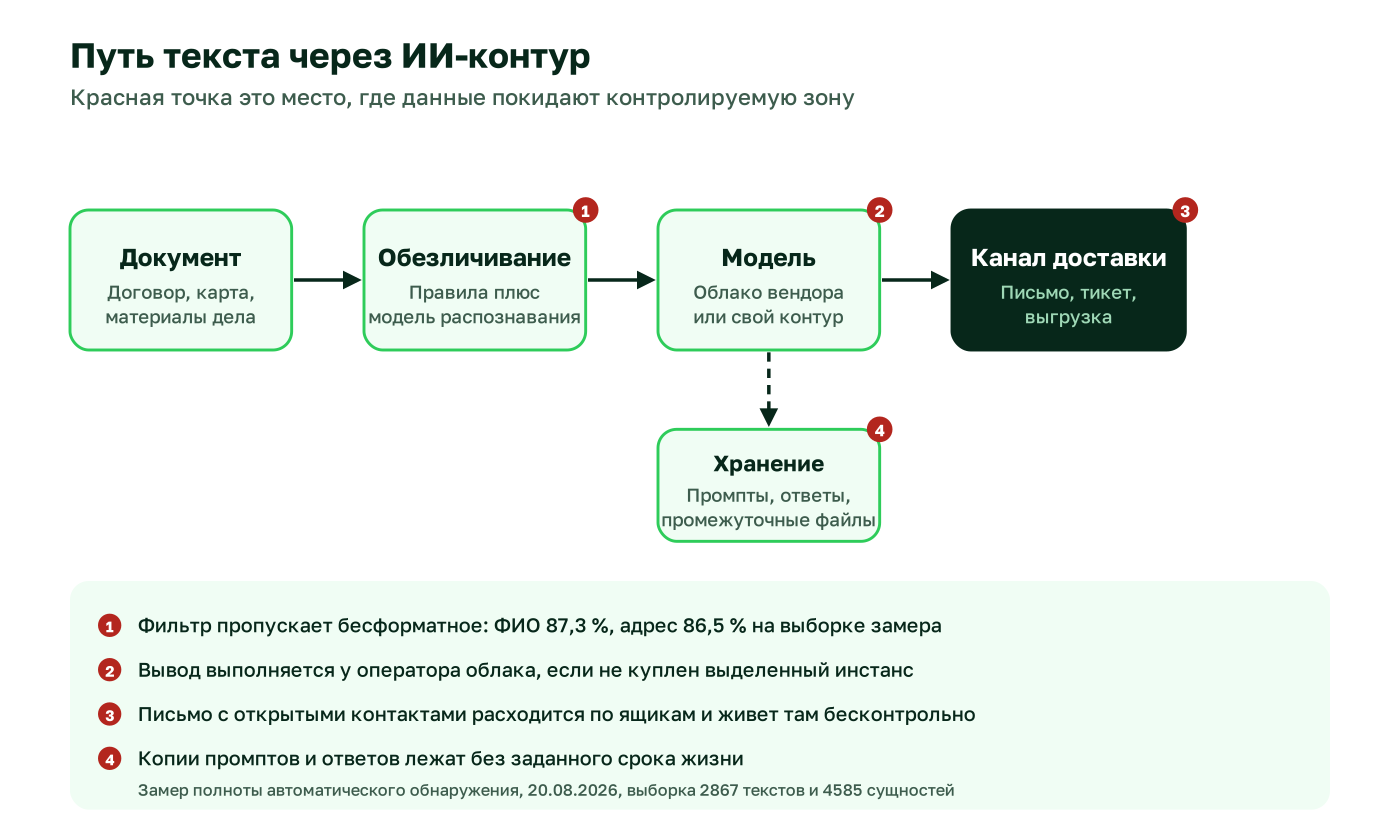
Тот же порядок проверки работает и для модели: сначала смотрим канал доставки результата, потом хранение, и только потом саму модель. Разбор ИИ-канала начинается именно с этого.
Сколько персональных данных находит автоматика
Второй вопрос: если тексты перед подачей в модель обезличивают автоматом, насколько на этот автомат можно опереться. Ответ измеряется, а не предполагается.
Замер от 20 августа 2026 года, автоматический поиск персональных данных в переписке: выборка 2867 сообщений, 4585 размеченных сущностей, попадание считается по каждой сущности отдельно, а не по документу целиком. Найдено 4241, пропущено 344, ложных срабатываний 301. Сводное покрытие 92,5 процента на этой выборке.
| Категория | Сущностей | Покрытие | Ложных срабатываний |
|---|---|---|---|
| Технические идентификаторы | 340 | 98,8 % | 3 |
| Финансовые данные | 198 | 98,0 % | 15 |
| Государственные идентификаторы | 639 | 97,8 % | 32 |
| Контакты | 290 | 97,6 % | 10 |
| Документы | 851 | 96,7 % | 10 |
| Организации | 166 | 92,8 % | 72 |
| ФИО | 986 | 87,3 % | 48 |
| Адрес и геолокация | 1111 | 86,5 % | 111 |
Таблица распадается на две части, и граница проходит не по важности данных, а по наличию формата. Паспорт, СНИЛС, ИНН, номер карты, телефон и почта имеют жесткую структуру и контрольные цифры. Их берет регулярное выражение с проверкой, и там 96,7 процента и выше.
Фамилия, адрес и название организации формата не имеют. Их приходится доставать языковой моделью по контексту, и результат заметно ниже: 87,3 и 86,5 процента. На эти три категории приходится 287 пропусков из 344 и 231 ложное срабатывание из 301. Внутри адреса хуже всего район 80,7 процента и город 81,2, внутри имени фамилия 84,4.
Теперь наложите это на судебное решение. Материалы дела состоят ровно из фамилий, адресов и названий организаций. То есть автоматическое обезличивание работает хуже всего именно на том типе данных, которым такой документ заполнен целиком. Полнота автоматического обнаружения по этой причине не гарантируется и оговаривается в договоре: 92,5 процента это не 100, а разница целиком приходится на самое чувствительное.
Что это меняет в порядке работы
Отсюда практический порядок, одинаковый для суда и для интернет-магазина.
Первое. Обезличивание не отменяет человека. Автомат снимает объем: он вычищает то, что имеет формат, и делает это почти без ошибок. Остаток по фамилиям, адресам и организациям смотрит специалист. Схема, где автомат работает один и никто не проверяет, дает предсказуемую дыру примерно в том месте, где документ наиболее чувствителен.
Второе. Ложные срабатывания это тоже проблема. 301 ложное срабатывание на выборке означает, что часть осмысленного текста будет затерта. Если модель потом принимает решение по затертому тексту, ошибка появится не от утечки, а от потери смысла. Полнота и точность настраиваются вместе, и порог выбирается под задачу.
Третье. Канал доставки важнее модели. Результат работы модели куда-то уезжает: в письмо, в мессенджер, в тикет, в выгрузку. По разбору контуров течет чаще всего именно там. Проверять контур надо с конца, а не с начала.
Четвертое. Срок хранения задается явно. Промпты, ответы модели и промежуточные файлы это тоже копии персональных данных. У них должен быть срок жизни и механизм удаления, а не намерение когда-нибудь почистить. Подробнее про инвентаризацию таких копий в разборе где лежат персональные данные помимо базы.
Сколько стоит держать модель у себя
Главный технический вопрос звучит так: выпускать тексты в чужое облако или платить за контур, из которого они не выходят. Это вопрос про деньги, и на него есть публичные цифры.
Цены сняты с живых страниц вендоров 7 сентября 2026 года, все с НДС.
| Вариант | Цена | Что это значит для данных |
|---|---|---|
| YandexGPT Pro 5.1, синхронно | 0,8 ₽ за 1000 входящих и 0,8 ₽ за 1000 исходящих токенов | Текст уходит к оператору облака |
| YandexGPT Pro 5.1, асинхронно | 0,41 ₽ и 0,41 ₽ за 1000 токенов | То же, дешевле за счет отложенной обработки |
| YandexGPT Lite | 0,2 ₽ и 0,2 ₽ за 1000 токенов | То же, модель слабее |
| GigaChat Pro, пакет для юрлиц | 25 000 ₽ за 50 000 000 токенов, пакет действует месяц | Текст уходит к оператору облака |
| GigaChat Lite, пакет для юрлиц | 19 500 ₽ за 300 000 000 токенов, пакет действует месяц | То же, модель слабее |
| Выделенный инстанс Gemma 3 4B, конфигурация S | 408,70 ₽ в час | Модель работает на отдельных мощностях |
| Выделенный инстанс Qwen 2.5 7B, конфигурация S | 817,40 ₽ в час | Модель работает на отдельных мощностях |
Источники: страница цен Yandex AI Studio и тарифы GigaChat для юридических лиц, обе проверены 7 сентября 2026 года.
Разрыв виден сразу. Обращение к общей облачной модели стоит доли рубля за документ. Выделенный инстанс при круглосуточной работе дает от 294 264 до 588 528 рублей в месяц: это пересчет часовой ставки вендора на 24 часа и 30 дней, а не цифра из прайса. Разница между этими двумя суммами и есть цена того, чтобы тексты не покидали периметр.
Отсюда практический вывод для среднего бизнеса: гнать все подряд через выделенный контур экономически бессмысленно. Разделяйте потоки. Обезличенные и малочувствительные тексты идут в общую модель по токенам, чувствительный поток либо в выделенный контур, либо не в модель вовсе. Разделение потоков это архитектурное решение, и принимать его надо до запуска, а не после инцидента.
Публичной статистики о том, какая доля российских компаний держит модель в изолированном контуре, в открытых источниках на дату публикации нет. Поэтому здесь только проверяемые цены вендоров, без оценок доли рынка.
Чек-лист перед запуском модели на своих документах
Семь пунктов, каждый проверяется за один рабочий день.
- Нарисовать путь текста от источника до получателя результата, включая письма и выгрузки.
- Назвать оператора инфраструктуры, где выполняется вывод модели, и условия обработки в его договоре.
- Измерить, сколько персональных данных пропускает ваш фильтр, на своей выборке, а не на демо вендора.
- Посмотреть отдельно на фамилии, адреса и организации: там будет основная часть пропусков.
- Пройти канал доставки результата и найти в нем открытые контакты.
- Задать срок хранения промптов, ответов и промежуточных файлов и проверить, что удаление реально срабатывает.
- Записать, кто принимает решение по результату работы модели. Автоматическое решение без человека это отдельный правовой вопрос.
Пункт три обычно вызывает возражение: измерять долго и дорого. На практике размеченная выборка в 200 реальных текстов дает достаточную картину по категориям, чтобы понять, где именно у вас дыра.
Разбор ИИ-канала по вашей выборке
Берем 200 реальных текстов из вашего контура, показываем что нашли и где течет. 10 рабочих дней, 49 000 ₽. Пресейл-прогон бесплатный. Доработки по итогам 2 500 ₽/ч, оплата по факту, без аванса.
Вопросы и ответы
Правда ли, что модель запоминает персональные данные из обучающей выборки
Такой риск существует и изучается, но он не первый по вероятности. При разборе контуров данные обычно уходят через письмо-уведомление и через хранение без заданного срока, а не через саму модель. Проверять контур стоит начиная с канала доставки результата.
Насколько можно доверять автоматическому обезличиванию
По замеру от 20 августа 2026 года на выборке 2867 текстов и 4585 сущностей автомат нашел 92,5 процента при 301 ложном срабатывании. Данные с жестким форматом (паспорт, СНИЛС, карта, телефон, почта) находятся на уровне 96,7 процента и выше. Фамилии 87,3 процента, адреса 86,5. Полнота автоматического обнаружения не гарантируется и оговаривается в договоре.
Почему фамилии и адреса находятся хуже, чем номер паспорта
У номера паспорта есть формат и контрольные цифры, его берет проверяемое правило. У фамилии формата нет, ее приходится определять по контексту языковой моделью. Внутри адреса хуже всего распознаются район 80,7 процента и город 81,2 процента, внутри имени фамилия 84,4 процента.
Сколько стоит держать модель так, чтобы тексты не уходили в чужое облако
По ценам от 7 сентября 2026 года выделенный инстанс в Yandex AI Studio стоит 408,70 ₽ в час за Gemma 3 4B и 817,40 ₽ за Qwen 2.5 7B в конфигурации S. При круглосуточной работе это от 294 264 до 588 528 ₽ в месяц: часовая ставка вендора умножена на 24 часа и 30 дней. Обращение к общей облачной модели стоит доли рубля за документ.
С чего начать, если модель уже работает на наших документах
С двух вещей. Нарисовать путь текста от источника до получателя результата и проверить канал доставки на открытые контакты. Дальше измерить пропуски фильтра на своей выборке, а не на демо вендора. Кто отвечает, если модель ошиблась, разбирали отдельно в материале про галлюцинации нейросетей и ответственность.
Коротко
Пилот в судах это повод посмотреть на собственный контур, а не сюжет про роботов-судей. Механика везде одна: текст с персональными данными проходит через фильтр, попадает в модель и уезжает получателю. Фильтр хорошо справляется с форматными данными и заметно хуже с фамилиями и адресами, а течет чаще всего не модель, а канал доставки. Обе вещи измеряются за несколько дней, и до запуска это дешевле, чем после.
Смежные разборы: методы обезличивания по 152-ФЗ, требования к персональным данным в ИИ-канале и ИИ-ассистент для юристов.
Обсудим вашу задачу
Оставьте контакт: ответим в течение 2 часов в рабочее время. Оценка бесплатная, аванс не нужен.